




Chúng tôi đã xử lý tình trạng DB phình to do hàng triệu email như thế nào: Đệm bằng AWS SQS và lưu trữ trên Azure Blob
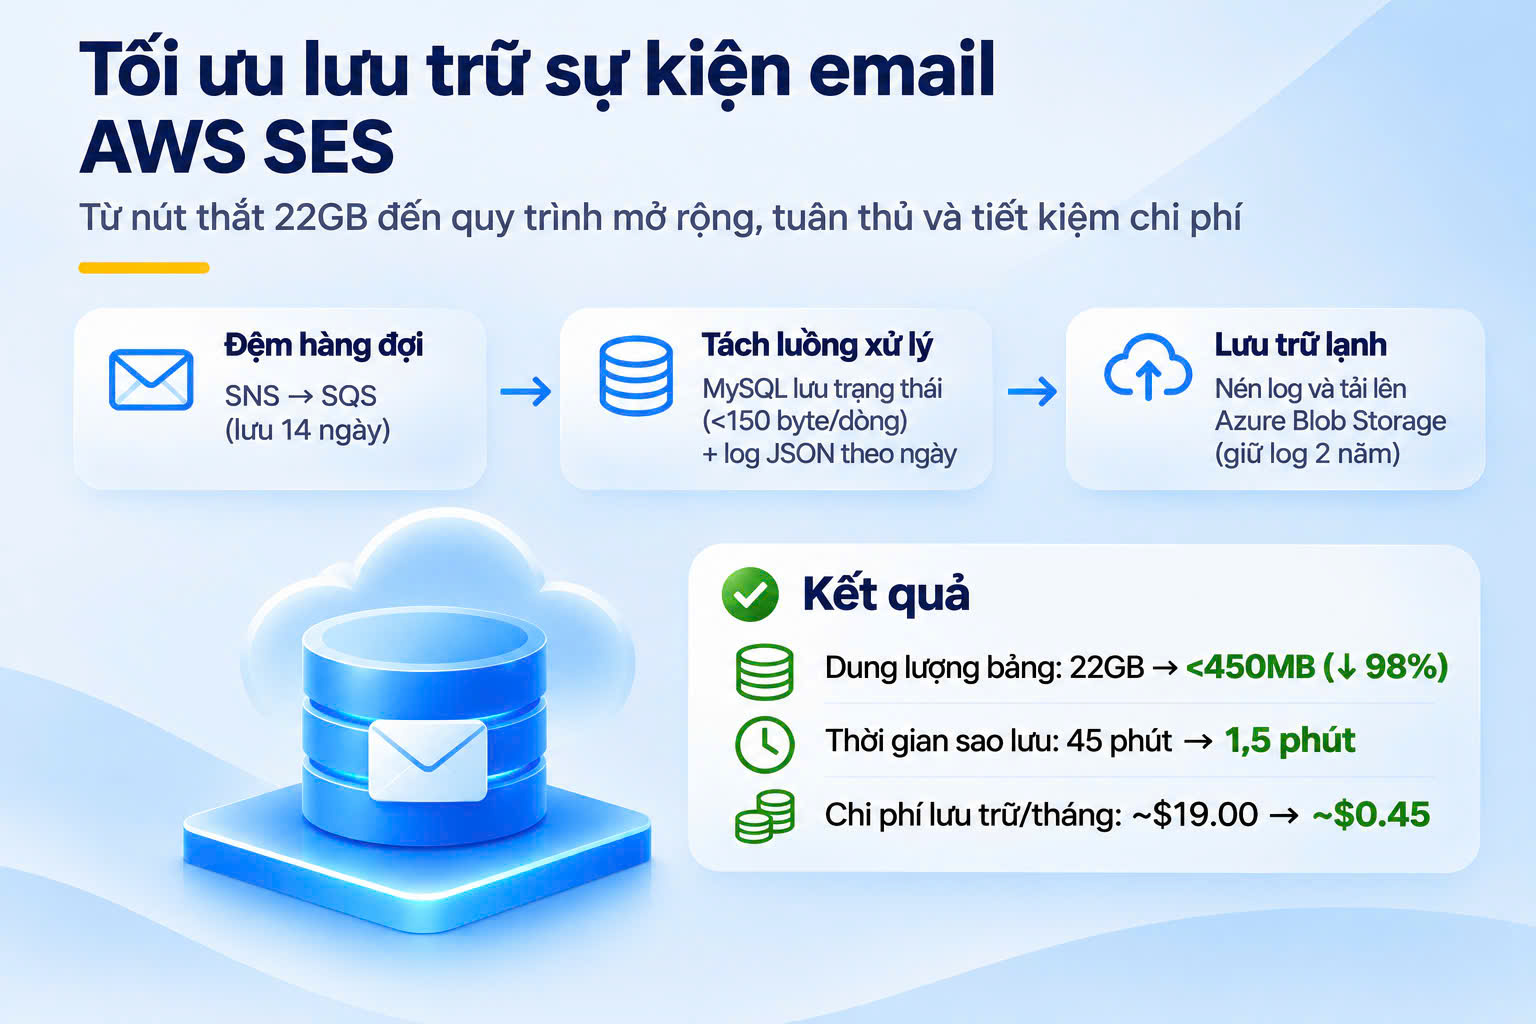
Bảng log email trên Amazon RDS for MySQL đã vượt quá 22GB, khiến truy vấn chậm đi và bản sao lưu hằng đêm kéo dài tới 45 phút. Đồng thời, yêu cầu tuân thủ buộc chúng tôi phải lưu giữ nguyên vẹn log kiểm toán trong 2 năm. Bài viết này giới thiệu cách chúng tôi thiết kế lại pipeline: đệm các sự kiện trạng thái bằng Amazon SQS, ghi payload chi tiết ra Monolog và lưu trữ các file nén trên Azure Blob Storage.
- “Cái bẫy của sự tiện lợi”: Đưa mọi thứ vào cơ sở dữ liệu
Ứng dụng của chúng tôi chạy trên AWS, với backend sử dụng Amazon RDS for MySQL cấu hình Multi-AZ (Region Tokyo, ap-northeast-1). Khi triển khai email giao dịch, cách nhanh nhất là tạo bảng `aws_mail_events`. Mỗi lần gửi email hoặc mỗi khi có callback, chúng tôi ghi trực tiếp người nhận, trạng thái và payload phản hồi thô vào cột `LONGTEXT`. Với vài trăm email thử nghiệm mỗi ngày trên môi trường staging, cách làm này hoàn toàn không có vấn đề gì.
Vấn đề chỉ xuất hiện khi cổng thông tin bắt đầu xử lý lưu lượng production: 600,000 email mỗi tháng cho đăng nhập, xác minh danh tính, thông báo và báo cáo. Mỗi lần gửi phát sinh nhiều callback vòng đời như Send, Delivery, và đôi khi cả Bounce hoặc Complaint.
Sau nửa năm vận hành, ba điểm nghẽn đã lộ diện.
- Bảng phình to: Bảng đạt tới 10 triệu dòng / 22GB, chiếm phần lớn dung lượng lưu trữ được cấp phát.
- Sao lưu chậm: Script sao lưu logic hằng đêm (mysqldump lên S3) làm bão hòa Disk I/O và mất hơn 45 phút để quét hàng triệu dòng TEXT.
- Truy vấn trên màn hình quản trị chậm: Màn hình dashboard quản trị lọc theo trạng thái trở nên chậm, vì InnoDB buffer pool tiêu tốn bộ nhớ để cache các khối văn bản lớn thay vì các trang index.
- Đệm sự kiện: Vì sao HTTP endpoint là chưa đủ
Amazon SES phát hành các sự kiện gửi thư thông qua Amazon SNS. SNS có thể push trực tiếp tới HTTPS webhook trên web server và cũng có chính sách gửi lại. Tuy nhiên, theo tài liệu của AWS, tổng thời gian gửi lại tới HTTP/S endpoint không được vượt quá 3,600 giây (1 giờ). Đây là giới hạn cứng. Nếu xảy ra bảo trì kéo dài, một lần deploy bị lỗi, hoặc deadlock cơ sở dữ liệu kéo dài quá 1 giờ, việc gửi lại tới webhook phía nhận sẽ bị dừng và các sự kiện chưa xử lý sẽ mất vĩnh viễn.
Vậy sao không gắn trực tiếp Dead Letter Queue vào HTTP subscription của SNS? Điều đó không hiệu quả, vì DLQ của SNS chỉ bắt các message sau khi mọi lần gửi lại đều thất bại, chứ không đóng vai trò bộ đệm kiểu pull để kiểm soát tốc độ tiêu thụ. Khi gửi số lượng lớn, hệ thống vẫn phải hứng trọn các đợt push tăng đột biến theo thời gian thực, và còn phải tự xây dựng cơ chế xử lý lại các request thất bại.
Vì vậy, chúng tôi chuyển sự kiện sang đi qua hàng đợi: Amazon SES → Amazon SNS → hàng đợi Amazon SQS.
Thời gian lưu giữ message mặc định của Amazon SQS là 4 ngày, chúng tôi đã đặt lên mức tối đa 14 ngày. Worker chạy nền dùng Long Polling (`WaitTimeSeconds: 20`) để lấy message theo lô 10 message mỗi lần, giảm thiểu số lần poll rỗng. Vì SQS hoạt động như bộ đệm kiểu pull, backend có thể tiêu thụ sự kiện theo tốc độ của riêng mình. Ngay cả khi tầng Web đang bảo trì, message vẫn nằm an toàn trong hàng đợi mà không lo bị mất.
- Tách dữ liệu: Metadata trong cơ sở dữ liệu và log dạng file
Trên thực tế, 99% truy vấn hằng ngày trên màn hình quản trị chỉ cần các trường cơ bản: địa chỉ email, timestamp, trạng thái gửi và template ID. Toàn bộ payload chẩn đoán JSON gồm 30 trường do SES trả về chỉ cần đến khi điều tra một trường hợp bị từ chối cụ thể. Không có lý do gì để lưu các chuỗi JSON lớn trong bảng giao dịch.
Vì vậy, chúng tôi chia đầu ra của worker thành hai luồng.
- Cơ sở dữ liệu: Chỉ ghi `message_id`, `event_type`, `email`, `status`, `created`. Cột văn bản `payload` đã bị loại bỏ. Kích thước mỗi dòng giảm xuống dưới 150 byte.
- Monolog: Toàn bộ header, mã chẩn đoán và phản hồi của MTA từ xa được ghi ra ổ đĩa bằng `RotatingFileHandler` và `JsonFormatter`. Việc ghi nối tiếp (append) diễn ra tuần tự và không gây khóa kết nối cơ sở dữ liệu.
- Lưu trữ dài hạn: Vì sao chọn Azure Blob Storage
Vì ứng dụng của chúng tôi chạy trên AWS, lẽ ra Amazon S3 là lựa chọn tiêu chuẩn. Tuy vậy, chúng tôi chọn Azure Blob Storage vì phía doanh nghiệp khách hàng yêu cầu tập trung log tuân thủ và kho lưu trữ kiểm toán trên Microsoft Azure. Log đang hoạt động của 30 ngày gần nhất được lưu ở tầng Cool của Azure Blob và được truy cập trực tiếp từ dashboard kiểm toán cũng như các dịch vụ phân tích của doanh nghiệp. Nhờ sử dụng SAS URL của Azure Blob, chúng tôi có thể tải trực tiếp lên container cần thiết mà không phải cấu hình IAM role phức tạp giữa các đám mây.
Nhờ nén gzip, file log JSON hằng ngày giảm khoảng 75%. Lưu lượng egress hằng tháng từ AWS sang Azure dưới 2GB, chi phí khoảng 0.23 USD mỗi tháng (0.114 USD/GB từ AWS ap-northeast-1).
Việc quản lý phân tầng lưu trữ tuân theo lifecycle rule của Azure Blob.
- Tầng Cool (ngày 1–30): Log đang hoạt động của 30 ngày gần nhất, có thể truy cập để phục vụ kiểm toán tuân thủ và lập báo cáo hằng ngày.
- Tầng Archive (ngày 31–730): Theo lifecycle rule, log quá 30 ngày sẽ tự động chuyển sang tầng Archive (0.00099 USD/GB/tháng), đáp ứng yêu cầu lưu giữ 2 năm theo quy định. Dữ liệu ở tầng Archive không được dùng cho phân tích hay báo cáo hằng ngày. Chỉ khi có đợt kiểm toán chính thức từ cơ quan quản lý, đội vận hành mới thực hiện rehydrate theo yêu cầu (mất từ 1–15 giờ).
Cũng cần lưu ý thời gian lưu giữ tối thiểu: tầng Cool tối thiểu 30 ngày, tầng Archive tối thiểu 180 ngày; xóa sớm sẽ phát sinh phí. Để đáp ứng yêu cầu tuân thủ, chúng tôi bật Time-Based Retention Policies (WORM) trên container nhằm ngăn việc xóa nhầm.
Một cron job chạy lúc 01:00 mỗi đêm sẽ nén file Monolog của ngày hôm trước, tải lên Azure Blob Storage, xác nhận tải lên thành công rồi mới xóa file cục bộ. Sau khi xác nhận, một truy vấn khác sẽ xóa các dòng trong cơ sở dữ liệu cũ hơn 30 ngày. Nhờ đó, bảng vận hành luôn được giữ dưới 450MB.
- Kết quả và so sánh chi phí
Sau 3 tháng vận hành pipeline mới, môi trường của chúng tôi đạt được các hiệu quả sau.
|
Chỉ số |
Trước cải tiến |
Sau cải tiến |
|
Kích thước bảng log DB |
22 GB (hơn 10 triệu dòng) |
450 MB (dữ liệu 30 ngày) |
|
Thời gian sao lưu DB hằng đêm |
45 phút |
1.5 phút |
|
Chi phí lưu trữ & egress hằng tháng |
Khoảng 19.00 USD (RDS Multi-AZ + lưu trữ sao lưu) |
Khoảng 0.45 USD (Azure Storage + egress + SQS) |
|
Thời gian lưu giữ / đệm sự kiện |
Tối đa 1 giờ (giới hạn gửi lại HTTP của SNS) |
Tối đa 14 ngày (cấu hình trên SQS) |
Ghi chú về chi phí: Chi tiết cơ cấu chi phí:
|
Thành phần |
Cơ cấu chi phí (ap-northeast-1) |
|
Trước đây (khoảng 19.00 USD/tháng) |
• Lưu trữ RDS Multi-AZ gp3: 22GB × 0.23 USD/GB = 5.06 USD |
|
Mới (khoảng 0.45 USD/tháng) |
• Lưu trữ đã nén trên Azure Cool (30 ngày) + Archive (700 ngày): khoảng 0.15 USD |
|
Mức tiết kiệm ròng |
Giảm khoảng 98% chi phí lưu trữ và sao lưu hằng tháng (khoảng 18.55 USD/tháng). |
- Đánh đổi và rủi ro kiến trúc
Thiết kế này đã giải quyết điểm nghẽn về lưu trữ và sao lưu cơ sở dữ liệu, nhưng cũng phát sinh ba sự đánh đổi cần lường trước.
- Khoảng thời gian đệm trên ổ đĩa cục bộ (rủi ro RPO 25 giờ): Log được xoay vòng trên ổ đĩa máy chủ cho đến job tải lên lúc 01:00, nên có thể tồn tại khoảng thời gian chưa tải lên tối đa 25 giờ. Việc mất trace JSON thô khi instance gặp sự cố là rủi ro mà dự án đã chủ động chấp nhận, vì metadata nghiệp vụ đã được lưu trong MySQL. Nếu yêu cầu không mất dữ liệu ngay cả với payload thô, hãy lên lịch đồng bộ mỗi giờ hoặc mount một volume mạng bền vững (EFS/EBS).
- Bảo mật và xoay vòng SAS token: SAS token được xử lý giống như bearer token. Chúng tôi giới hạn quyền chỉ ghi (`w`), thu hẹp phạm vi vào container đích, đặt thời hạn hiệu lực ngắn và xoay vòng tự động bằng AWS Secrets Manager.
- Tính bất đồng bộ khi truy xuất dữ liệu kiểm toán: Log ở tầng Cool có thể truy cập ngay, nhưng khi lấy log cũ hơn 30 ngày từ tầng Archive thì cần lên kế hoạch tính đến độ trễ của quá trình rehydrate.
- Bài học rút ra từ vận hành
Việc vận hành pipeline này trên production đã làm rõ ba yêu cầu triển khai cực kỳ quan trọng.
- Đảm bảo tính idempotent: Amazon SQS chỉ đảm bảo gửi “ít nhất một lần” (at-least-once). Chúng tôi đảm bảo tính idempotent bằng cách kiểm tra khóa duy nhất kết hợp `(message_id, event_type)` trước khi chèn dòng vào cơ sở dữ liệu.
- Cấu hình Dead Letter Queue (DLQ): Việc parse JSON có thể thất bại do payload sai định dạng hoặc bộ ký tự không mong đợi. Hãy luôn gắn Dead Letter Queue với `maxReceiveCount: 5` để cách ly các message lỗi và ngăn worker bị crash lặp đi lặp lại không dứt.
- Quản lý Suppression List tức thời: Khi sự kiện cho thấy Permanent Hard Bounce (hộp thư đích không tồn tại), địa chỉ đó được đưa ngay vào suppression list của ứng dụng. Việc dừng gửi tới địa chỉ này giúp duy trì tỷ lệ bounce SES của domain dưới 2% một cách thoải mái.
Kết luận
Cơ sở dữ liệu quan hệ được thiết kế cho các truy vấn giao dịch, không phải để làm kho lưu trữ log JSON chỉ ghi nối tiếp. Nhờ tách biệt hai loại dữ liệu này, tải trên cơ sở dữ liệu giảm đáng kể, thời gian sao lưu giảm từ 45 phút xuống 1.5 phút, và vẫn duy trì được yêu cầu tuân thủ kiểm toán 2 năm. Nếu các bảng trong ứng dụng của bạn đang phình to vì log sự kiện, hãy cân nhắc chuyển payload thô sang object storage lạnh trước khi hiệu năng truy vấn bị ảnh hưởng.