




数百万通のメールによる DB 肥大化をどう解消したか:AWS SQS によるバッファリングと Azure Blob でのアーカイブ
Amazon RDS for MySQL 上のメールログテーブルは 22GB を超え、クエリが遅くなり、夜間バックアップは 45 分にまで伸びていました。同時に、コンプライアンス要件により監査ログを 2 年間そのまま保持する必要がありました。本稿では、ステータスイベントを Amazon SQS でバッファリングし、詳細なペイロードを Monolog へ書き出し、圧縮ファイルを Azure Blob Storage にアーカイブするという、パイプライン再設計の内容を紹介します。
- 「便利さの罠」:何でもデータベースに入れてしまう
当社のアプリケーションは AWS 上で稼働しており、バックエンドには Multi-AZ 構成の Amazon RDS for MySQL(東京リージョン、ap-northeast-1)を利用しています。トランザクションメールを実装する際、最も手早い方法は `aws_mail_events` テーブルを作ることでした。メールを送信するたび、またはコールバックが発生するたびに、宛先・ステータス・生のレスポンスペイロードを `LONGTEXT` 列へ直接書き込んでいました。ステージング環境で 1 日に数百通のテストメールを扱う分には、これで何の問題もありませんでした。
問題が現れたのは、ポータルが本番トラフィックを扱い始めてからです。ログイン、本人確認、通知、レポートのために月 600,000 通。1 回の送信ごとに Send、Delivery、場合によっては Bounce や Complaint といった複数のライフサイクルコールバックが発生します。
運用開始から半年で、三つのボトルネックが表面化しました。
- テーブルの肥大化: テーブルは 1,000 万行・22GB に達し、割り当てストレージの大部分を占めるようになりました。
- バックアップの遅延: 夜間の論理バックアップスクリプト(mysqldump から S3 へ)がディスク I/O を飽和させ、数百万行の TEXT をスキャンするのに 45 分以上かかるようになりました。
- 管理画面クエリの遅延: ステータスで絞り込む管理ダッシュボードの画面が遅くなりました。InnoDB バッファプールが、インデックスページではなく大きなテキストの塊をキャッシュするためにメモリを消費していたからです。
- イベントのバッファリング:HTTP エンドポイントでは不十分な理由
Amazon SES は配信イベントを Amazon SNS 経由で発行します。SNS は Web サーバー上の HTTPS webhook へ直接プッシュでき、再送ポリシーも備えています。しかし、 AWS のドキュメントによれば、HTTP/S エンドポイントに対する再送の合計時間は 3,600 秒(1 時間)を超えることができません。これはハードリミットです。長時間のメンテナンス、不具合のあるデプロイ、あるいは 1 時間を超えるデータベースのデッドロックが発生すると、受信側の webhook への再送は打ち切られ、未処理のイベントは永久に失われます。
では、SNS の HTTP サブスクリプションに直接 Dead Letter Queue を付ければよいのではないか。そうはいきません。SNS の DLQ は再送がすべて失敗した後のメッセージを捕捉するだけであり、消費速度を制御するためのプル型バッファにはならないからです。大量配信時にはリアルタイムのプッシュのスパイクをそのまま受けることになり、失敗したリクエストの再処理機構も自前で作る必要があります。
そこで、イベントをキュー経由に切り替えました: Amazon SES → Amazon SNS → Amazon SQS キュー。
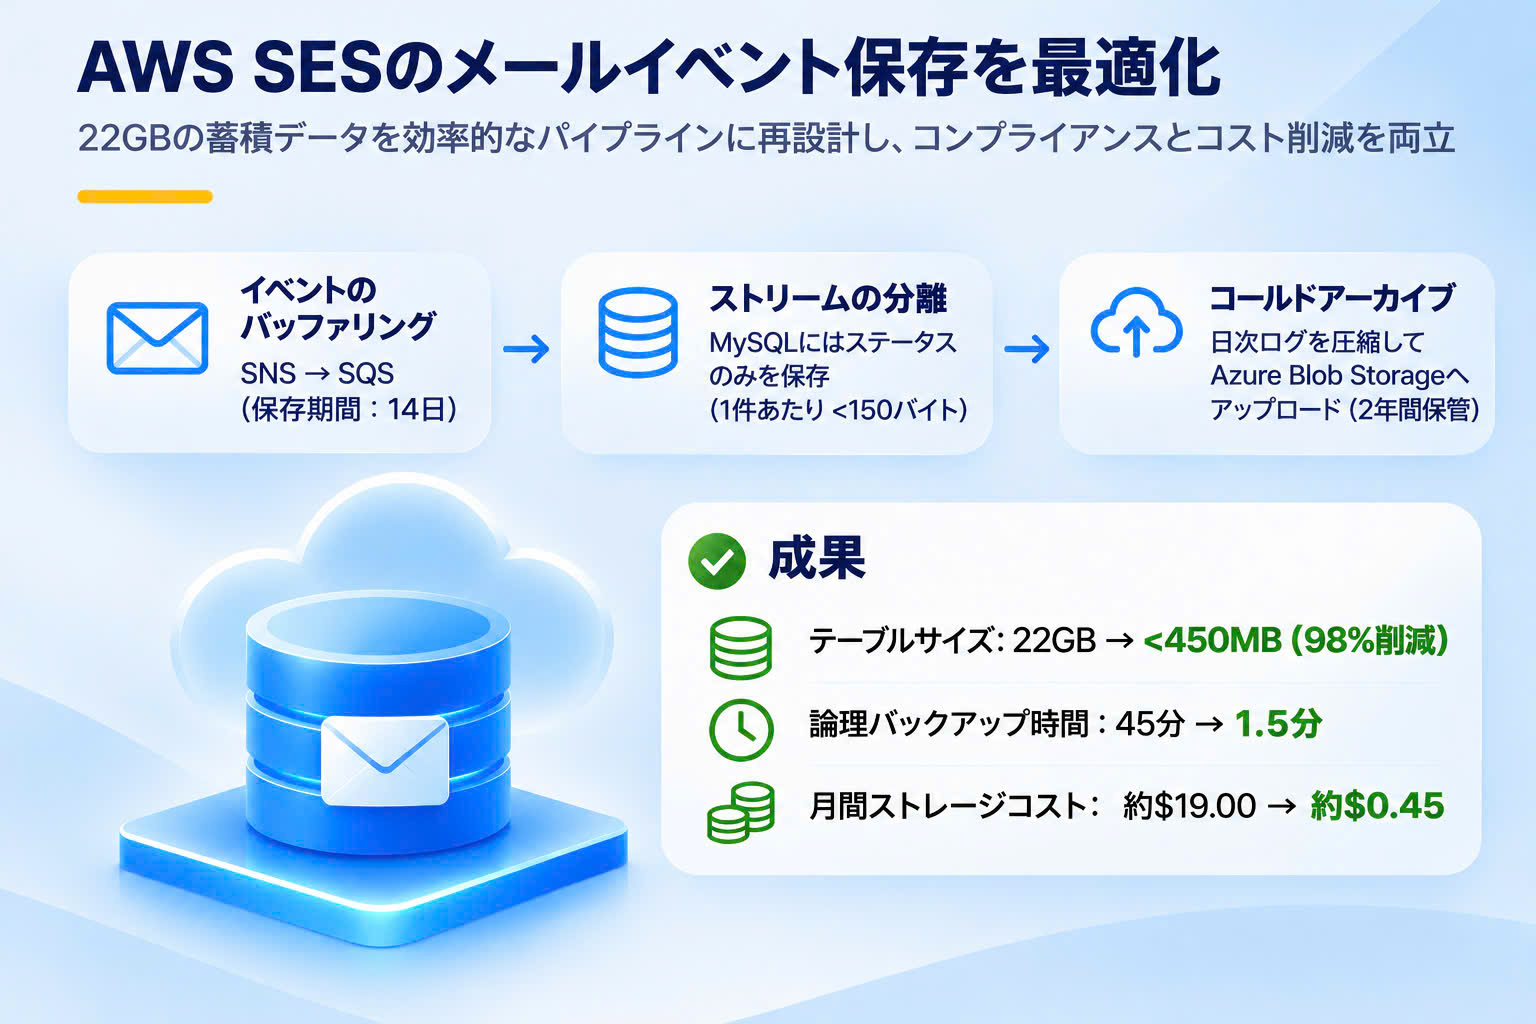
Amazon SQS のメッセージ保持期間は既定で 4 日ですが、これを最大の 14 日に設定しました。バックグラウンドのワーカーが Long Polling(`WaitTimeSeconds: 20`)で 10 件ずつまとめてメッセージを取得し、空ポーリングの回数を最小化します。SQS がプル型のバッファとして機能するため、バックエンドは自分のペースでイベントを消費できます。Web 層がメンテナンス中でも、メッセージは失われる心配なくキューに留まります。
- データの分割:データベースのメタデータとファイルログ
実際のところ、日々の管理画面での照会の 99% は基本的な項目しか必要としません。メールアドレス、タイムスタンプ、配信ステータス、テンプレート ID です。SES が返す 30 項目の JSON 診断ペイロード全体が必要になるのは、特定の拒否を調査するときくらいです。大きな JSON 文字列をトランザクション用テーブルに保存しておく必然性はありませんでした。
そこで、ワーカーの出力を二つの経路に分けました。
- データベース: `message_id`、`event_type`、`email`、`status`、`created` のみを書き込みます。テキスト列 `payload` は削除しました。1 行あたりのサイズは 150 バイト未満になりました。
- Monolog: ヘッダー、診断コード、リモート MTA のレスポンスをすべて、`RotatingFileHandler` と `JsonFormatter` を用いてディスクへ書き出します。追記処理はシーケンシャルで、データベース接続のロックを発生させません。
- 長期保存:なぜ Azure Blob Storage なのか
当社のアプリケーションは AWS 上で動いているため、本来であれば Amazon S3 が標準的な選択肢でした。それでも Azure Blob Storage を選んだのは、コンプライアンスログと監査アーカイブを Microsoft Azure に集約するという要件が顧客企業側にあったためです。直近 30 日のアクティブなログは Azure Blob の Cool 層に保存され、企業の監査ダッシュボードや分析サービスから直接参照されます。Azure Blob の SAS URL を利用することで、クラウド間の複雑な IAM ロール設定なしに、必要なコンテナーへ直接アップロードできました。
gzip 圧縮により、日次の JSON ログファイルは約 75% 削減されます。AWS から Azure への月間エグレスは 2GB 未満で、費用は月あたり約 0.23 USD です(AWS ap-northeast-1 から 0.114 USD/GB)。
ストレージの階層管理は、Azure Blob のライフサイクルルールに従っています。
- Cool 層(1〜30 日目): 直近 30 日のアクティブなログ。日常的なコンプライアンス監査やレポート作成のために参照できます。
- Archive 層(31〜730 日目): ライフサイクルルールにより、30 日を超えたログは自動的に Archive 層(0.00099 USD/GB/月)へ移行し、法定 2 年間の保持要件に対応します。Archive 層のデータは日常の分析やレポートには使用しません。正式な規制当局の監査が発生した場合に限り、運用チームがオンデマンドでリハイドレート(1〜15 時間を要する)を実行します。
最低保持期間にも注意が必要です。Cool 層は最低 30 日、Archive 層は最低 180 日で、早期に削除すると料金が発生します。コンプライアンス対応として、誤削除を防ぐためにコンテナーで Time-Based Retention Policies(WORM)を有効にしています。
毎晩 01:00 に実行される cron ジョブが、前日の Monolog ファイルを圧縮して Azure Blob Storage へアップロードし、アップロードの成功を確認してからローカルファイルを削除します。確認が取れた後、別のクエリが 30 日より古いデータベースの行を削除します。これにより、運用テーブルは常に 450MB 未満に保たれています。
- 結果とコスト比較
新しいパイプラインを 3 か月間運用した結果、当社環境では次の効果が得られました。
|
指標 |
改善前 |
改善後 |
|
DB ログテーブルのサイズ |
22 GB(1,000 万行超) |
450 MB(30 日分) |
|
夜間 DB バックアップ時間 |
45 分 |
1.5 分 |
|
月額ストレージ・エグレス費用 |
約 19.00 USD(RDS Multi-AZ + バックアップストレージ) |
約 0.45 USD(Azure Storage + エグレス + SQS) |
|
イベント保持期間・バッファ |
最大 1 時間(SNS の HTTP 再送上限) |
最大 14 日(SQS で設定) |
コストに関する補足: コスト内訳の詳細:
|
構成要素 |
コスト内訳(ap-northeast-1) |
|
従来(約 19.00 USD/月) |
• RDS Multi-AZ gp3 ストレージ:22GB × 0.23 USD/GB = 5.06 USD |
|
新規(約 0.45 USD/月) |
• Azure Cool(30 日)+ Archive(700 日)の圧縮済みストレージ:約 0.15 USD |
|
正味の削減額 |
月額のストレージ・バックアップ費用を約 98%(約 18.55 USD/月)削減。 |
- トレードオフとアーキテクチャ上のリスク
この設計はデータベースのストレージとバックアップのボトルネックを解消しましたが、あらかじめ想定しておくべき三つのトレードオフも生じました。
- ローカルディスク上のバッファ期間(RPO 25 時間のリスク): ログは 01:00 のアップロードジョブまでサーバーのディスク上でローテーションされるため、未アップロードの期間が最大 25 時間生じます。インスタンス障害時に生の JSON トレースを失うことは、業務上のメタデータが MySQL に保存済みであることを踏まえ、プロジェクトとして明示的に受け入れたリスクです。生ペイロードについてもデータ損失ゼロが求められる場合は、1 時間ごとの同期をスケジュールするか、永続的なネットワークボリューム(EFS/EBS)をマウントしてください。
- SAS トークンのセキュリティとローテーション: SAS トークンはベアラートークンと同様に扱われます。当社では権限を書き込みのみ(`w`)に限定し、対象コンテナーにスコープを絞り、有効期限を短く設定したうえで、AWS Secrets Manager により自動でローテーションしています。
- 監査データ取得の非同期性: Cool 層のログは即座に参照できますが、30 日より古いログを Archive 層から取り出す場合は、リハイドレートの遅延を見込んだ計画が必要です。
- 運用から得られた学び
このパイプラインを本番で運用したことで、実装上きわめて重要な三つの要件が明らかになりました。
- 冪等性の担保: Amazon SQS が保証するのは「少なくとも 1 回」の配信です。当社では、データベースに行を挿入する前に複合ユニークキー `(message_id, event_type)` を検証することで冪等性を担保しています。
- Dead Letter Queue(DLQ)の設定: 不正な形式のペイロードや想定外の文字セットにより、JSON のパースが失敗することがあります。`maxReceiveCount: 5` を設定した Dead Letter Queue を必ず付与し、問題のあるメッセージを隔離してワーカーが延々とクラッシュするのを防いでください。
- 即時 Suppression List の管理:イベントが Permanent Hard Bounce(宛先メールボックスが存在しない)を示した場合は、そのアドレスを直ちにアプリケーションのサプレッションリストへ登録します。以降の送信を止めることで、ドメインの SES バウンス率を 2% 未満に余裕をもって維持できます。
結論
リレーショナルデータベースはトランザクションのクエリのために設計されたものであり、追記専用の JSON ログアーカイブのためのものではありません。両者を分離したことで、データベースの負荷は大幅に下がり、バックアップ時間は 45 分から 1.5 分になり、2 年間の監査コンプライアンスもそのまま維持できました。アプリケーションのテーブルがイベントログで肥大化しているなら、クエリ性能の悪化に追い込まれる前に、生のペイロードをコールドなオブジェクトストレージへ移すことを検討してください。